软工卒于2026年吗?
前言: 写这篇小文时,正值fable新版上线,黄老板多事之秋,anthropic要ipo之际,外界风云际会,内心临窗听雨,轻打键盘,恍惚看到文字在指尖跳跃,手有余温,慢度光阴的意趣,也就此刻罢了。
第一章:4万字的PRD
“hi,我已经完成了一版PRD,连原型都做好了,要不早上做个需求评审呗?接下来就等你们研发上了~”,具有十年产品经验的老孙兴高采烈地问道。
“卧槽,PRD有4万字?…”,需求评审的时候,后端开发工程师小章眉头紧锁,喃喃自语。一抬头,发现旁边刘工在文档上划拉划拉划拉划拉…
“孙老师,这个功能为什么原型和文档中描述的好像完全不同呀?这是什么原因?”,有人提问。
只见孙老师弯腰低头靠近笔记本屏幕,扶了扶自己的金丝眼镜框,“哦,这是ai写的,我没仔细看…”。
于是,众人一阵沉默。
话题一转,“现在ai真强啊,你看这么复杂的原型都可以实现,前端代码大概1万行吧。可以这样…这样…,唉?这里为什么有这个功能,我好像没有设计这个功能…”。
老孙陷入滔滔不绝地自我陶醉状。
第二天,早会刚结束。
“小张啊,workbuddy是真牛啊,我就花了两天做了一个以前我想都不敢想的产品,但是小苗那边有一些想法,我觉得也很好,想在我这个产品上直接改一下。可能我们都不是研发,这个东西你能不能搞一台windows的机器,帮我部署一下吗?”
小张仔细看了产品背后的代码,竟然发现各种业务逻辑都是写死在代码中的。“王老师,如果小苗改动的时候,您也改动了,有冲突怎么办啊?另外,一定需要windows的机器吗?公司的机器都是运维统一管理的,不会直接分配裸机给研发的…”。
“啊?这我都没想到…”,王老师思考片刻,回答道。
隔日,由于PRD实在太长,小章于是直接把产品输出的PRD和原型图给了codex进行代码生成和自动code review。看着屏幕上流式跳出的think的字符,输出的复杂代码,小章在一下下的accept中逐渐进入状态。
上线前测试,bug数惊人。于是,小章把bug list直接给到codex进行bug fix。之后,一轮又一轮~
以上,可能是在多数团队正在发生的事情。利用ai进行疯狂生产,但是消费跟不上。具体来说,针对ai输出的制品不进行审核(过脑子),问出问题,就说是ai写的,不问,就是自己写的。但是这里的消费跟不上至少包含两种情况:
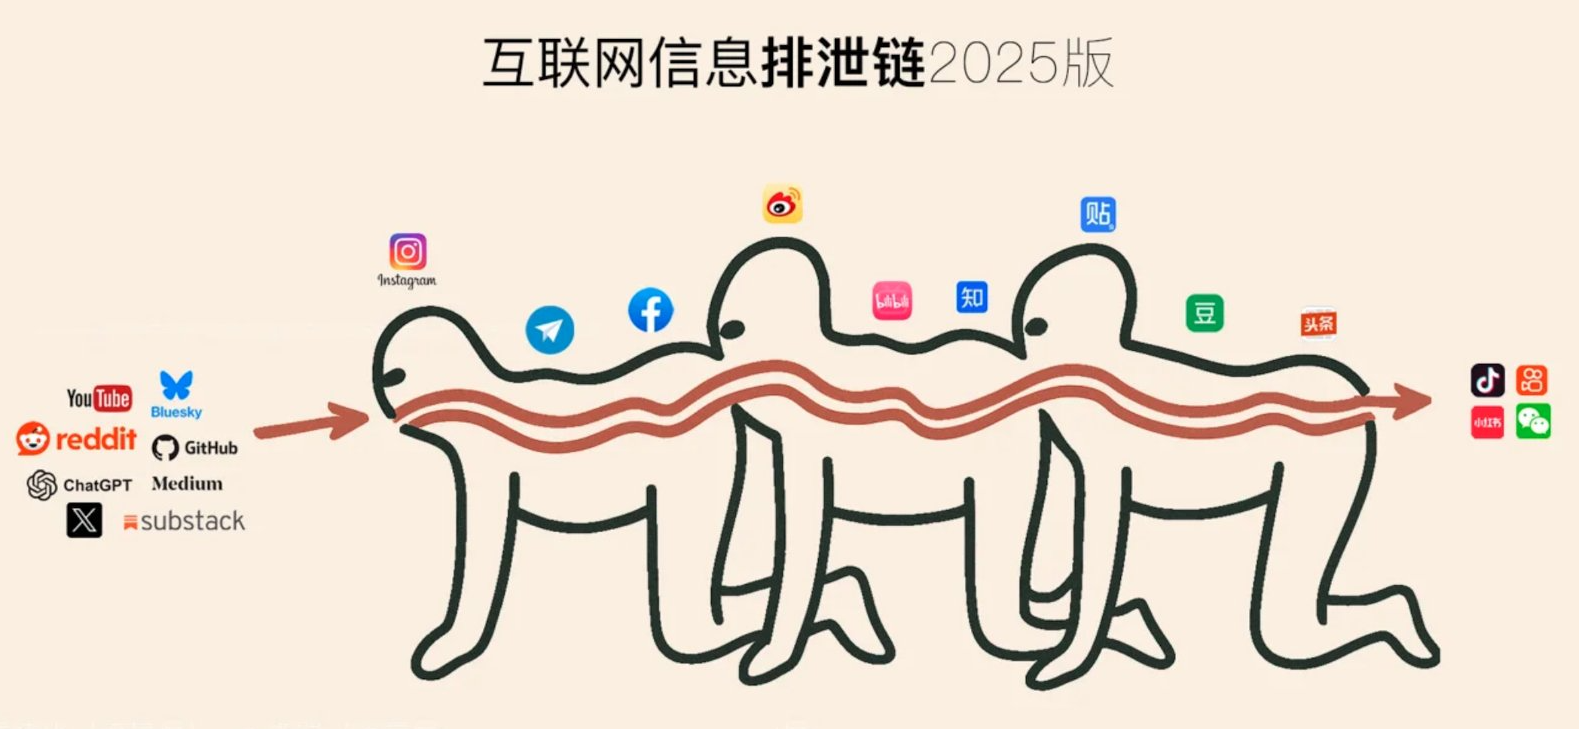
第一,制品太多以至于几乎无法消费。比如4万字的PRD,读一遍并深入思考的成本对于生成这个PRD的角色而言应该很高,另外,代码也是制品,复杂模块的人类code review的成本几乎是无法接受的,如果审不了,那就不审了。于是,小章直接把PRD作为代码生成的输入,中间生成的代码也不进行审核,直接流入测试环节等。不由自主地想到经典梗图,如下:
第二,主动意愿下的不审核。1秒生成的制品,在理论上可审核的条件下,假设需要10分钟去审核,这个动作几乎是反人性的。能够挑一些关键部分读一遍尚且显得难能可贵。于是乎出现老孙作为自己PRD的owner,无法回答评审时大家提出的问题等情况。
从生产者-消费者的逻辑关系讲,消费者并不关心消费的内容是ai生成的,还是人类写的,只要内容owner是人,能够对内容保持最大的解释权即可。道理是朴素的,但是由于是反人性的,故执行的时候确实比较困难。从另外一个角度讲,消费侧的人类某种程度上已经是全链路中的瓶颈。
大呼:读不完,是真的读不完!
如果这样的话,在ai生成的时候,可以增加约束只生成关键清晰的内容即可,比如参考andrej karpathy提出的生成文字/图表/HTML/视频的方法。当然,4万字PRD这种情况,不需要在下游做过多的信息压缩,经过原始的阶段之后,理论上会回到一个比较理想的状态。
对于王老师而言,缺的其实是将ai生成的制品回归真实世界的能力。部署只是一个具体动作而已,其他包括人的动机,时机,环境,企业上下文,权限等。理论上,非研发背景的同学直接从需求到代码进入生产环境,这件事必然是短时间内会发生的事情。
目前缺少的环节大抵来自现实的研发环境更多是为人准备的,并未完全进入ai-ready的状态。当然,对于复杂软件开发,在ai-ready的环境下,随着模型能力的持续提升,人类大抵也是打不过的。今天,之所以技术架构师仍具备存在的意义,可能要回归到一个基本问题上,那就是如何提出一个好问题?这背后需要的是技术审美和判断力。主动权还在人类手中,是因为这是一个主观且无法被自动化验证的问题。
非研发角色独自完成从build->go to market的全过程,没有中间商赚差价的那一天,马上就会到来。
第二章:算法卒?
六楼阳台抽烟的研发同学似乎越来越多了。
“我已经是一个合格的写python后端的算法了,哈哈哈哈哈”,小陈深吸一口气,吐出大片烟雾。
“是啊,想念19年那会儿,还能改改模型,调调参数,现在模型彻底没得搞了,根本搞不动,只能搞搞数据。agent其实都是在搞工程了,你说得对,大家都是后端,只是不写java而已…”,老侯摇了摇头,“算法工程师,首先是工程师,说得没错。可是后端和算法其实关注的内容还是不一样的。真去搞传统后端,未必有很大优势。”,老侯补充道。
从BiLSTM/RNN/CNN->BERT系/GPT早期系,中间包括GAN/VAE等,对于传统算法而言,似乎调参是个性感的工作。魔改损失函数,图模型加圈,神经网络模型加层的年代似乎一去不复返,对于绝大多数算法而言,确实如此。
围绕agent,事实上的架构标准也已经形成并在多数组织中落地。harness确实是一个更偏向于工程的范畴。在60分的水位上,一个java后端和python后端几乎没有明显区别(coding agent在快速拉平这种差距),但是在90分的agent水位上,一个算法似乎具有更多的优势,比如算法更加容易去回答这些问题:
(1)对话上下文太长会有什么影响,如何相对优雅地解决?
(2)一个agent中可以有无限多个mcp用来调用吗?如果不能,为什么?如何缓解?
(3)哪些场景下需要去微调一个embedding模型或者更小的模型?
对于深谙如何提出一个好问题的研发而言,在知识和智力显著贬值的今天,这些都不是问题。
正如互联网兴起之初一样,我们会追问“既然互联网上啥知识都有,那么为什么我们还要记忆一些知识呢?我搜不就行了”,在今天,一个算法至少拥有一个搜索返回时间的优势,而这,在多数情况下,已经足够了。
第三章:面向未来
从ai辅助人,到ai和人一起干活,到人跟着ai的意志干活。第三个阶段,可能很难让人接受,但是事实上已经发生了,从你在coding agent中放弃plan mode,直接auto accept的时候,就已经发生了。甚至在业务设计阶段,是ai完成了这件事,人只是帮助ai完成实际的落地,并赚一些token费用而已。
前端卒,前端卒,前端卒完测试卒,测试卒,测试卒,测试卒完算法卒。
但是,这就完了?不。
在今天,ai是一个能力放大器,对所有研发都是公平的。既然如此,未必需要我不得不把才华埋葬在昨天,何不积极拥抱,壮大自己?简单而言,从业务出发,就回到业务自身。避免研发职能的划分羁绊,主动打破边界不设限。
试问,一个业务学习技术更难,还是一个技术学习业务更难?如果认为后者比前者更容易,那就勇敢地冲吧。
扫码加笔者好友,茶已备好,等你来聊~